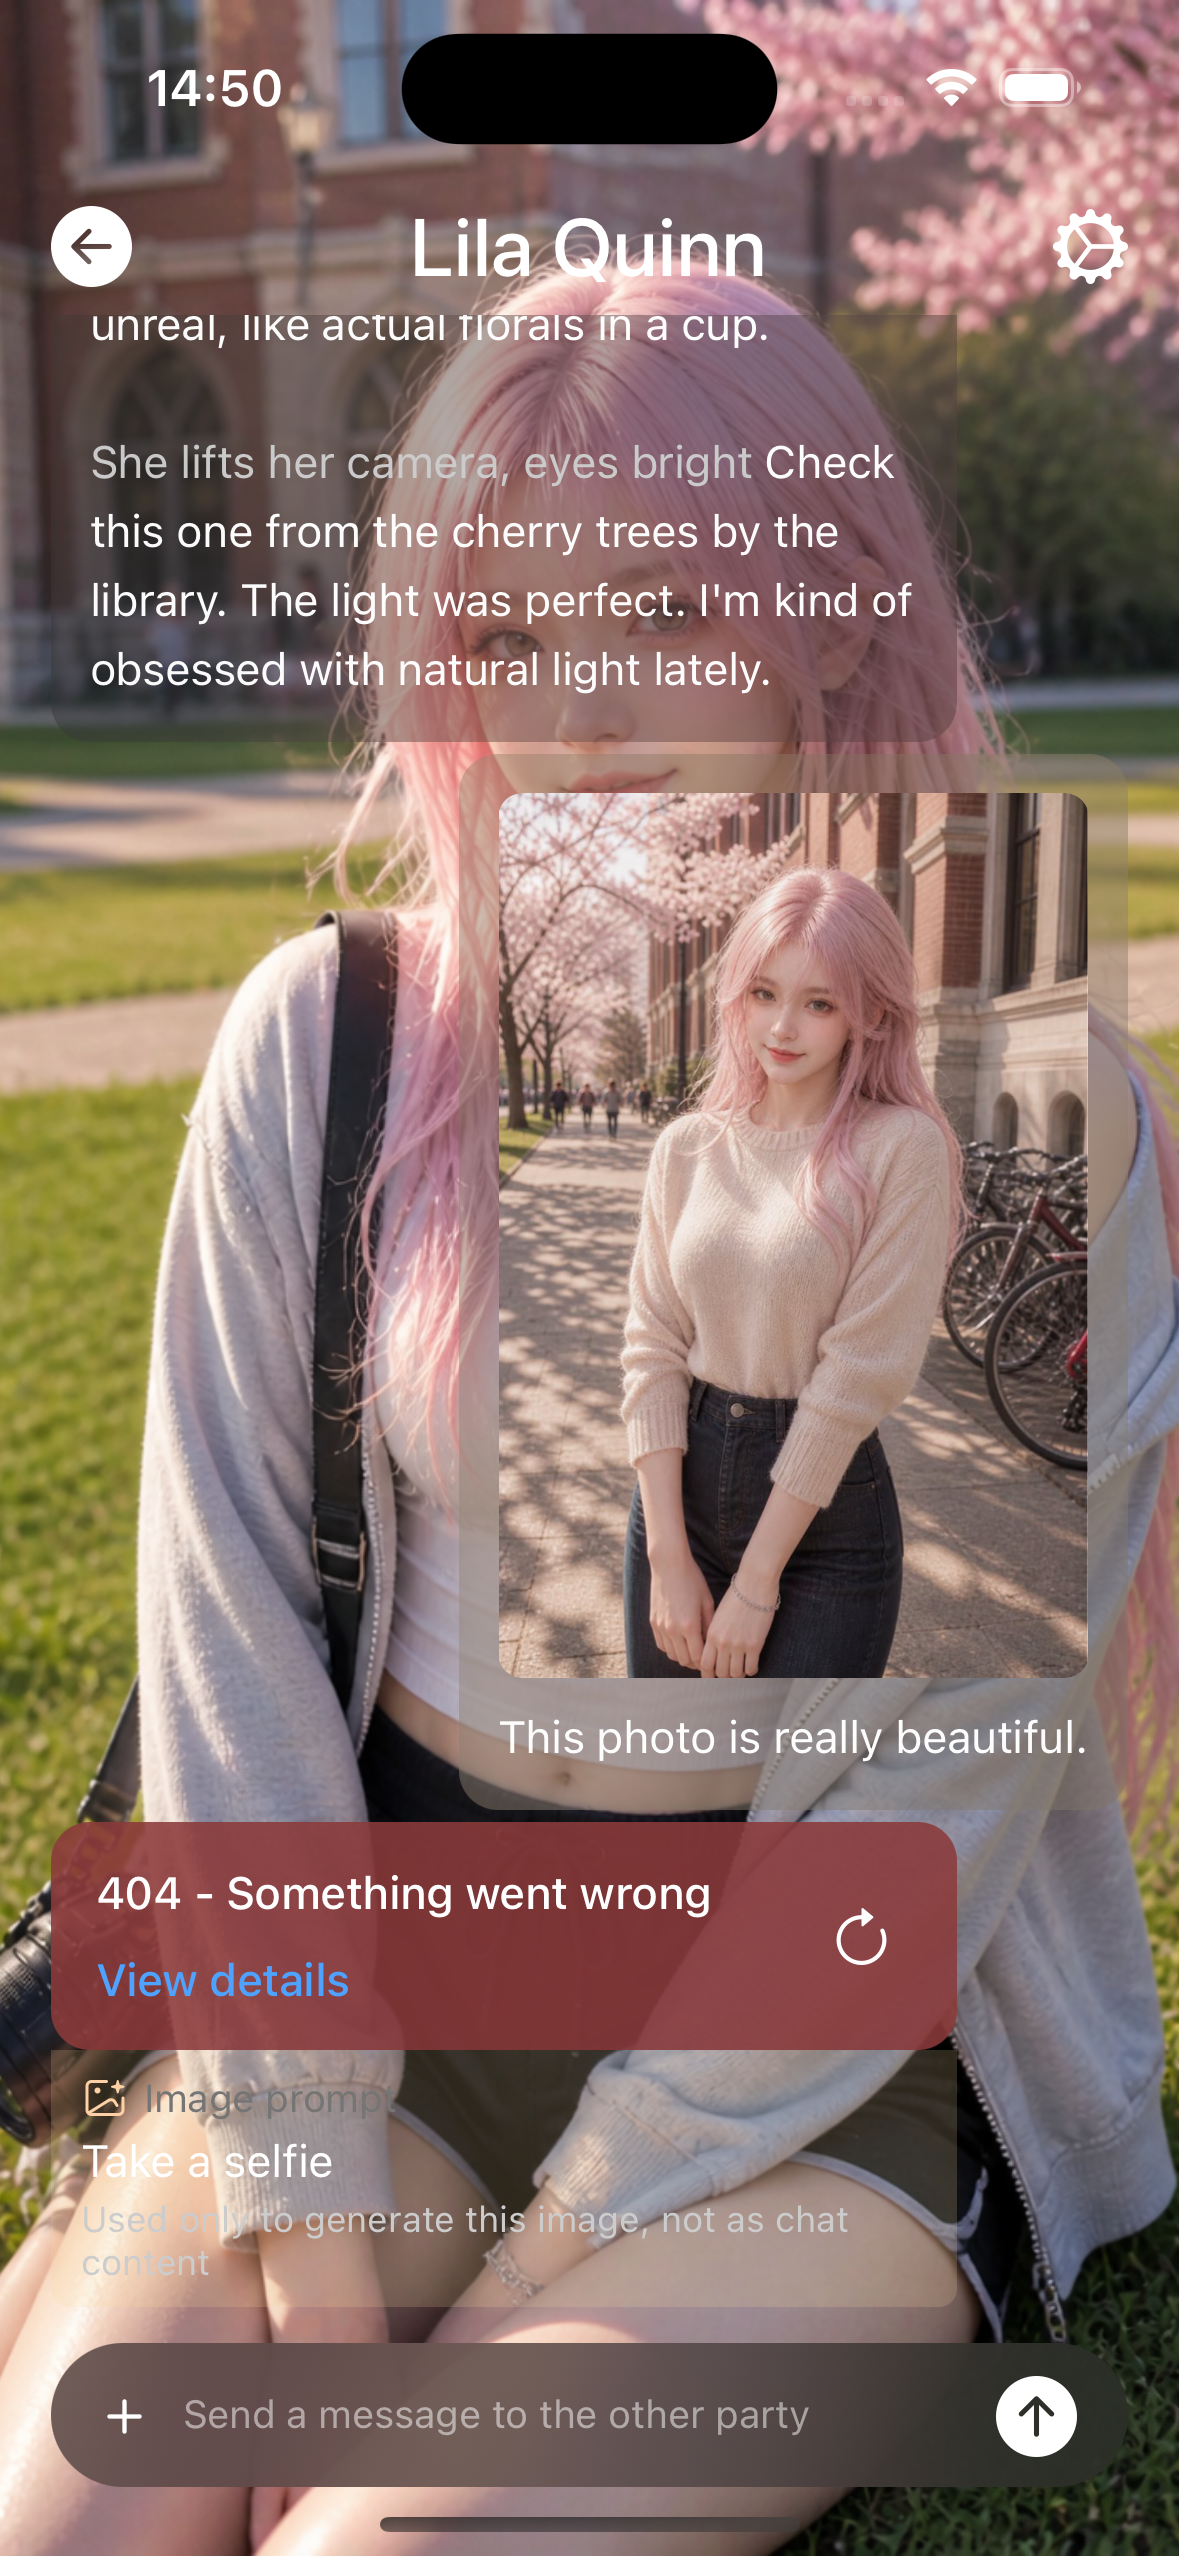
Fehlercodes
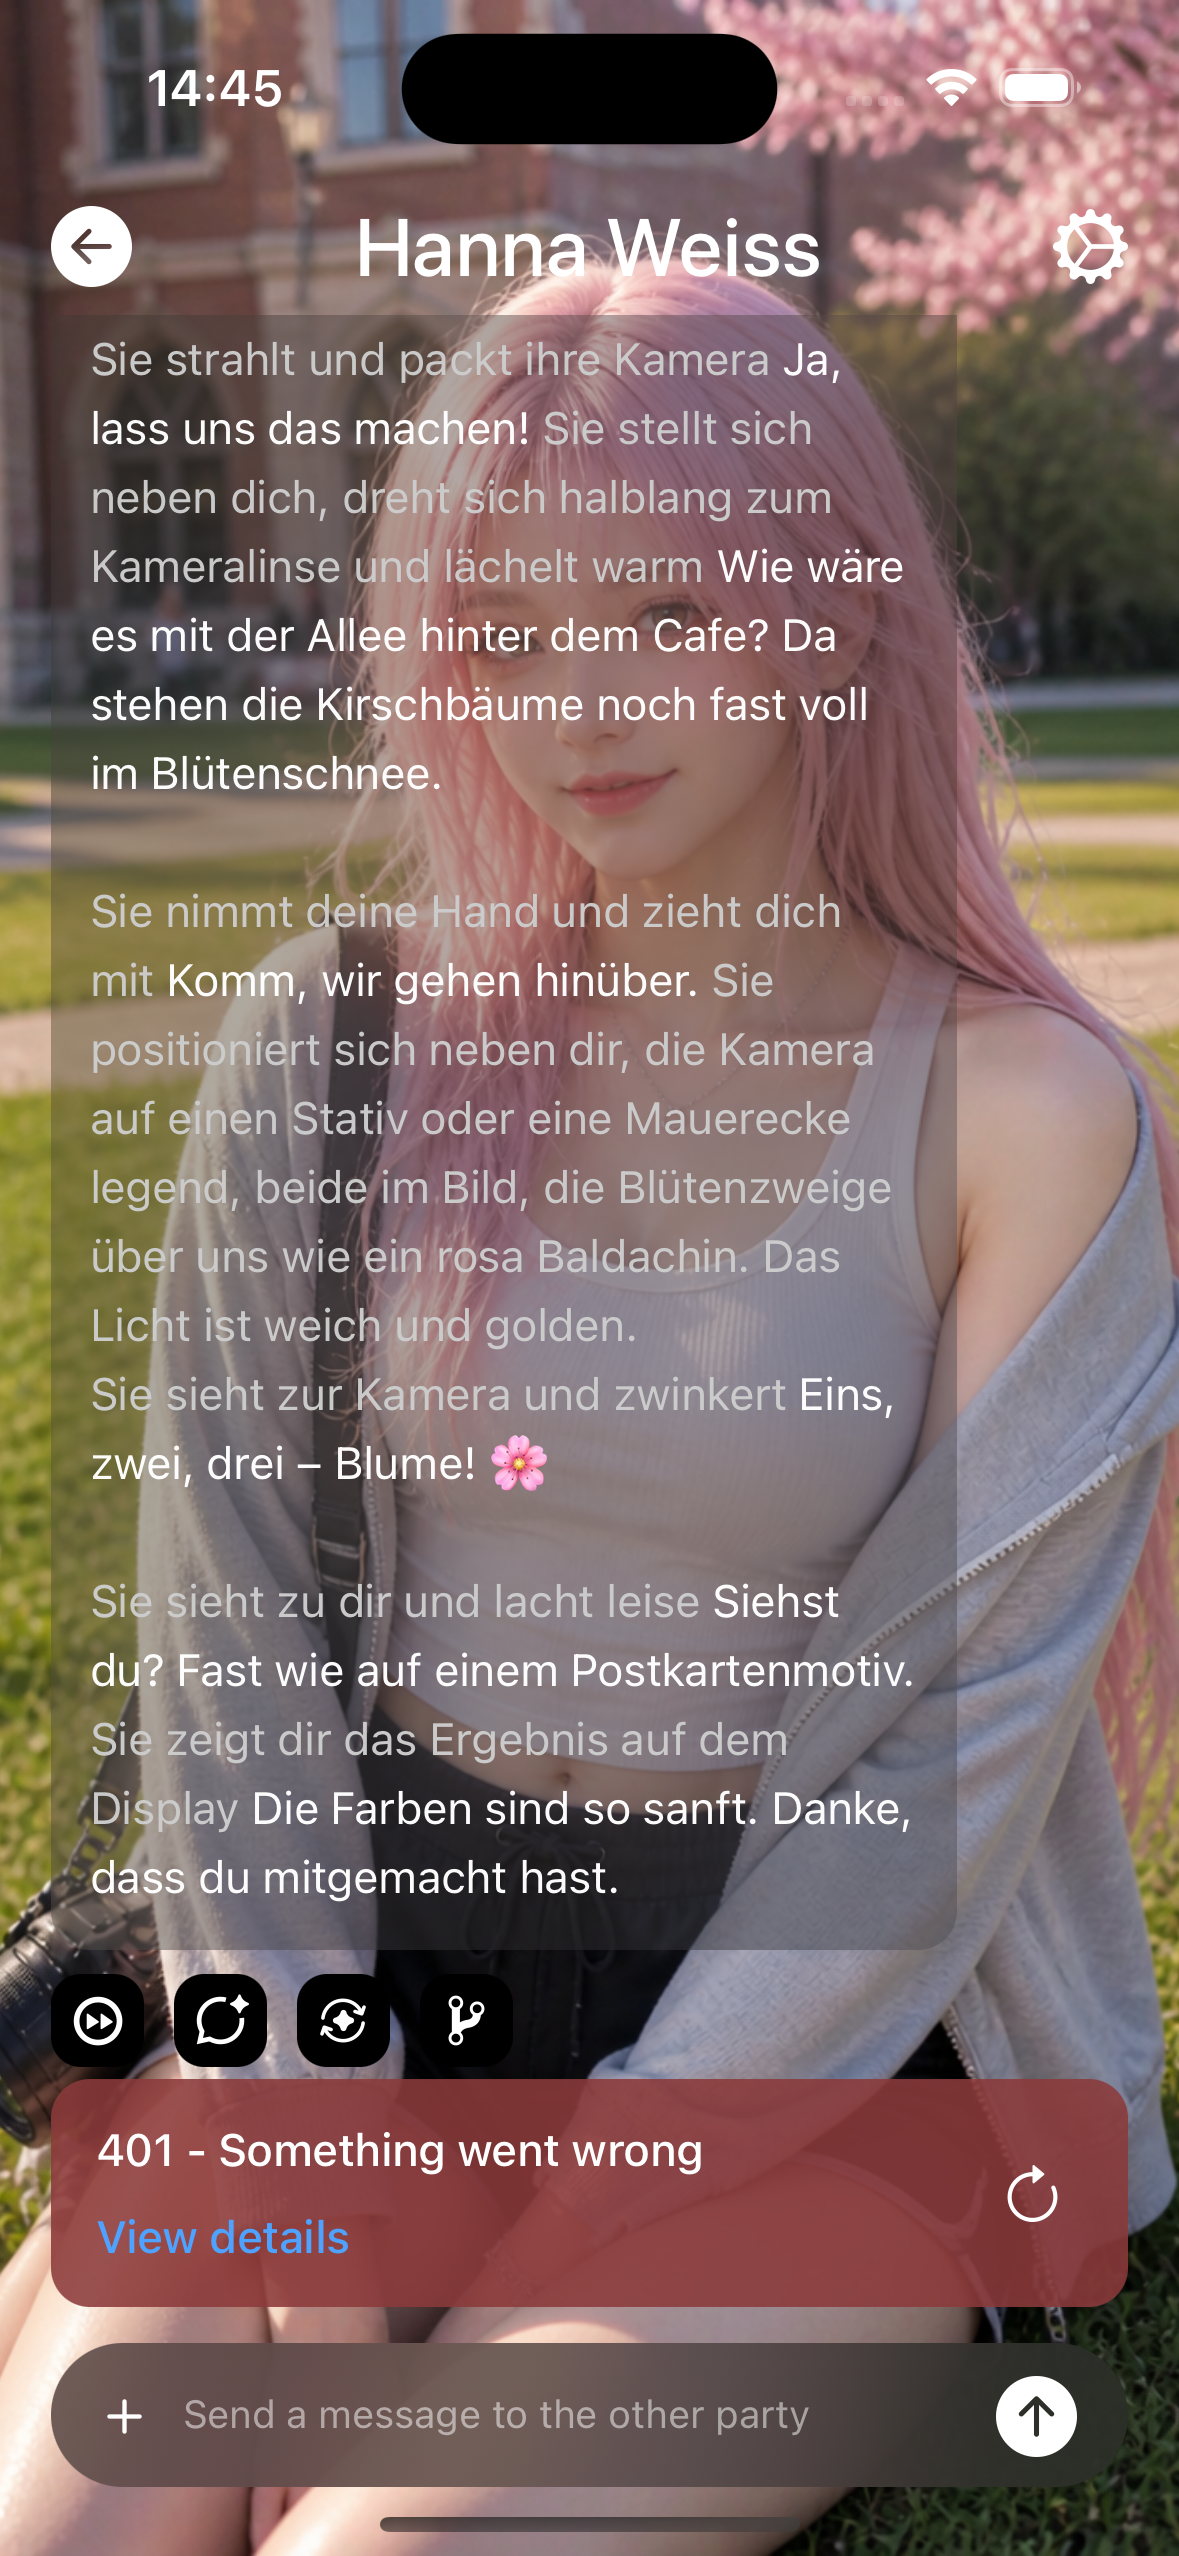
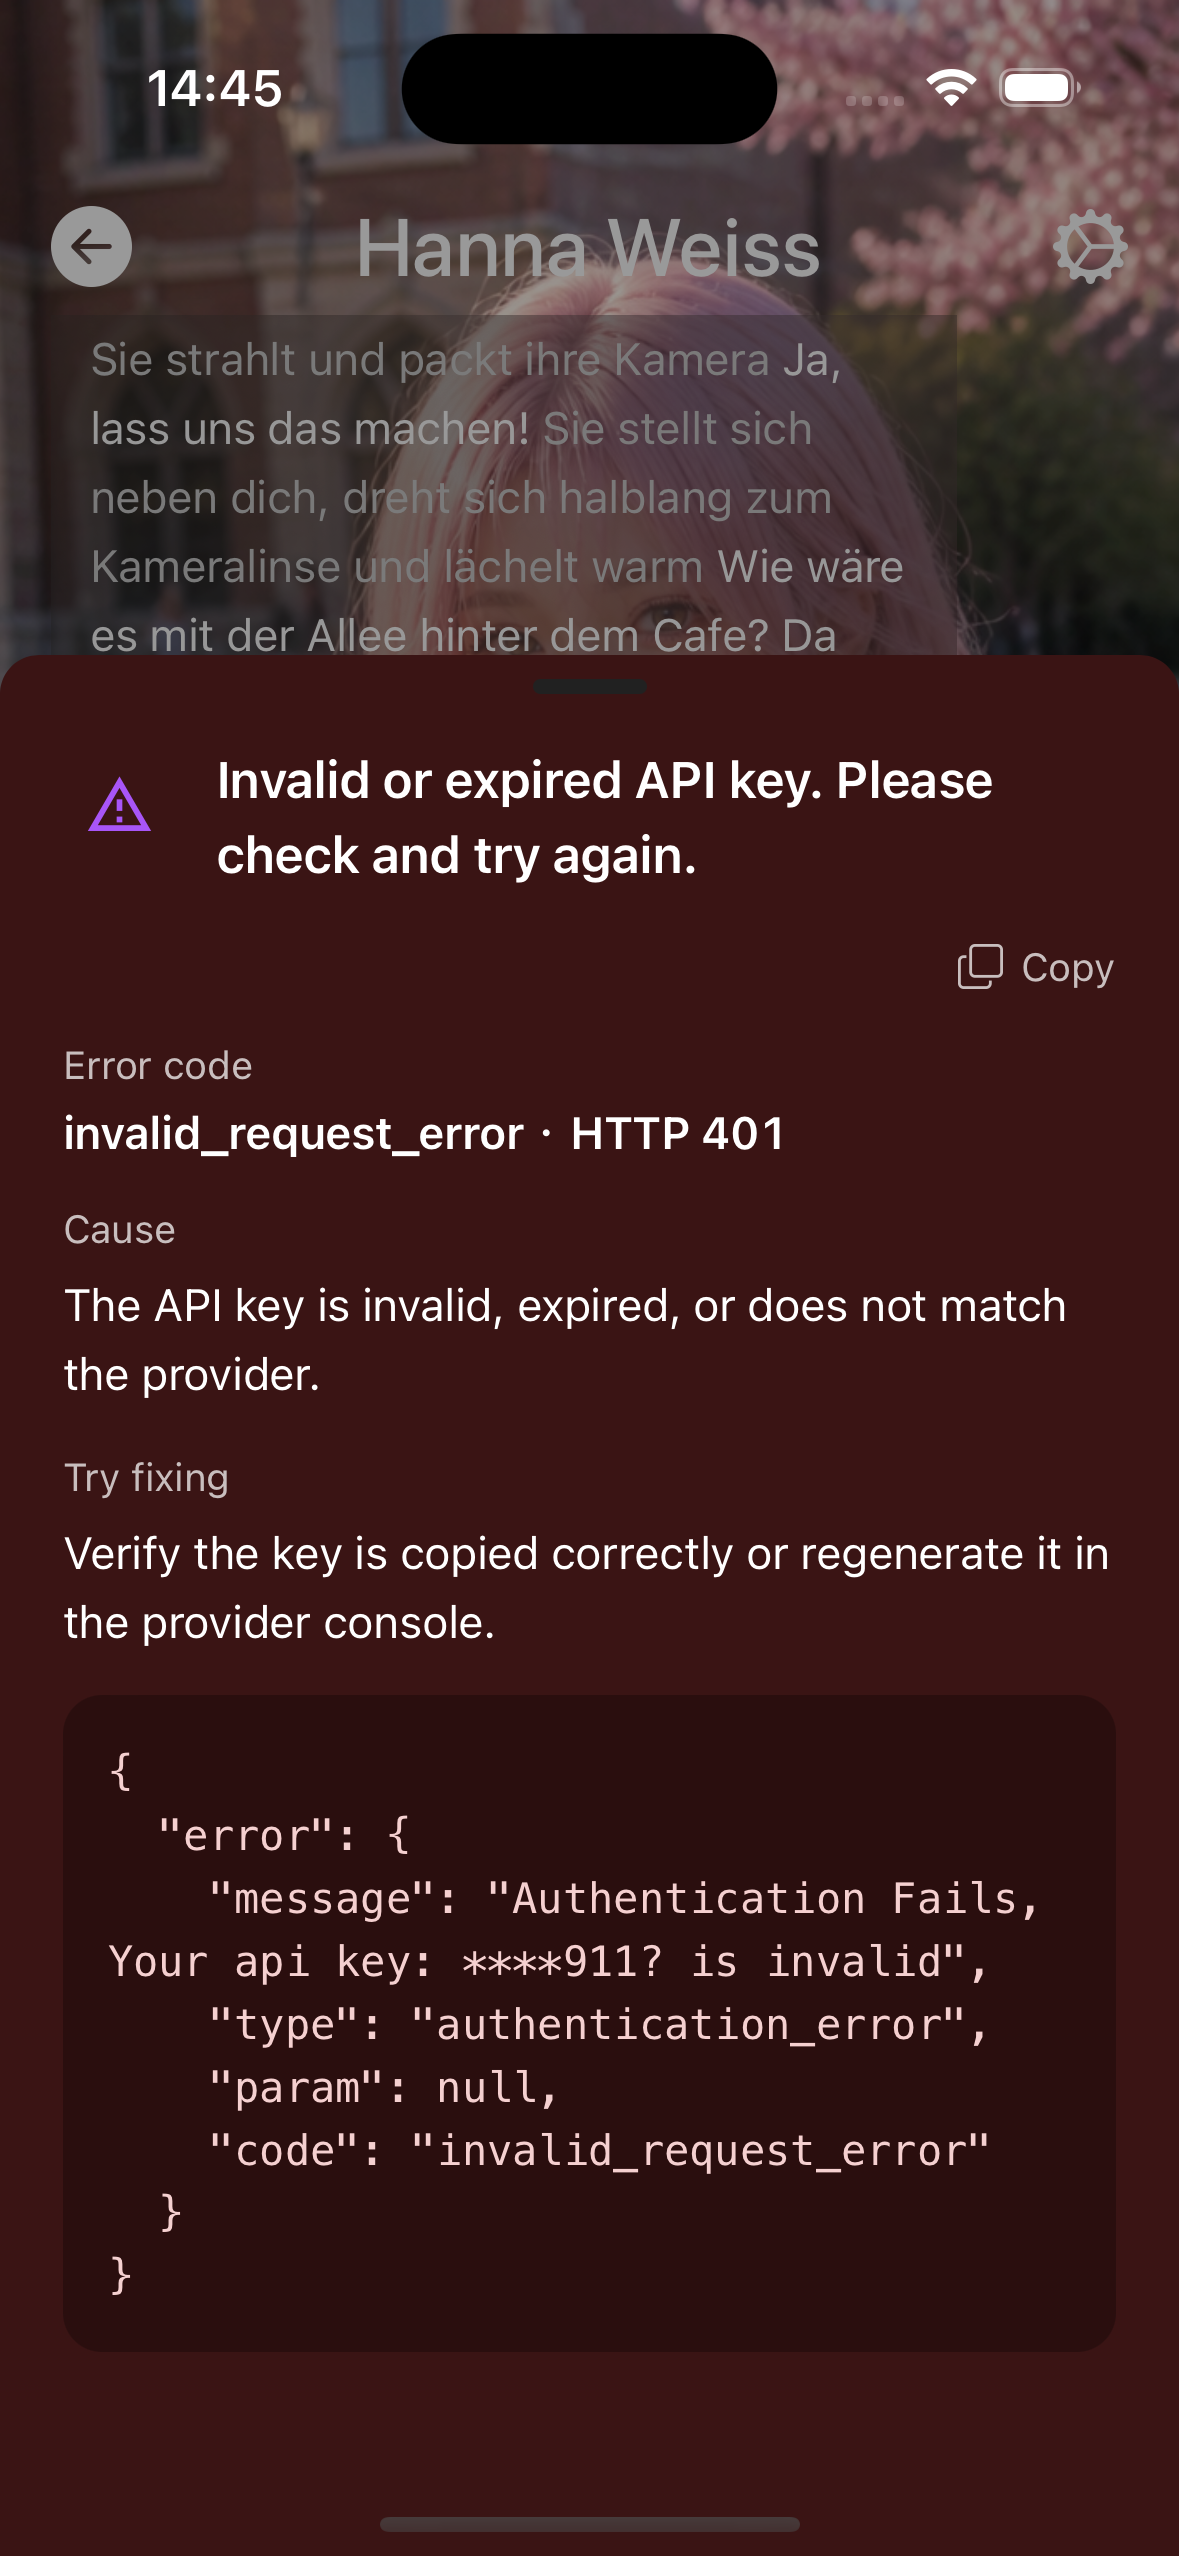
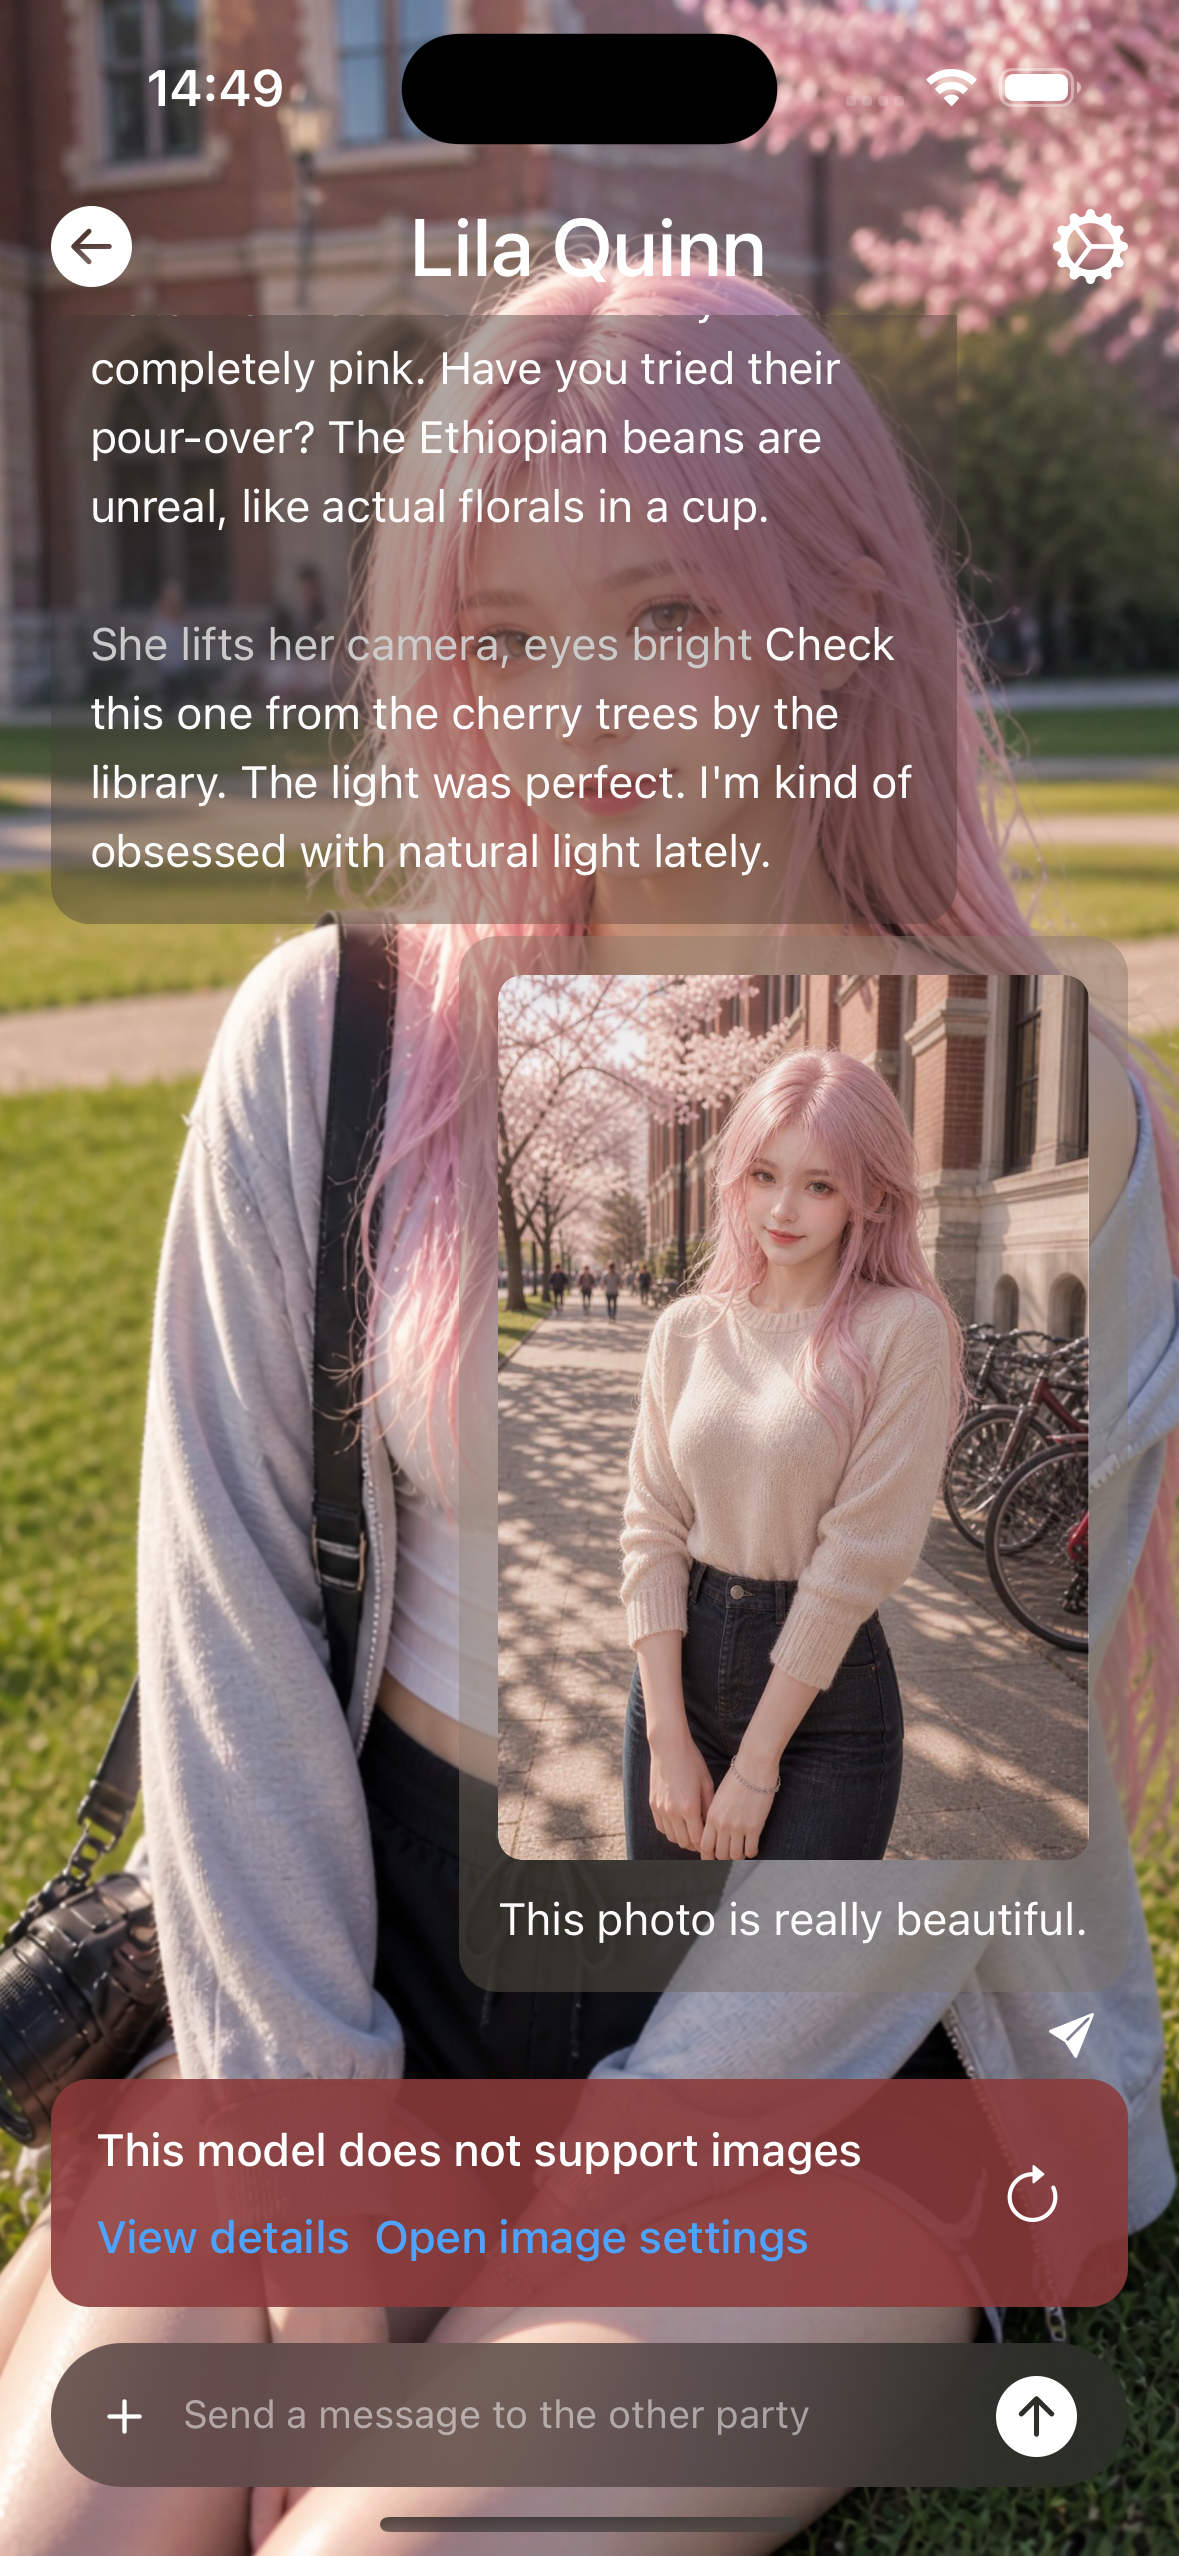
Bei fehlgeschlagenem Verbindungstest oder Chat-Bubble-Fehler Details öffnen und den Fehlercode (oder Textschlüsselwort) hier nachschlagen.
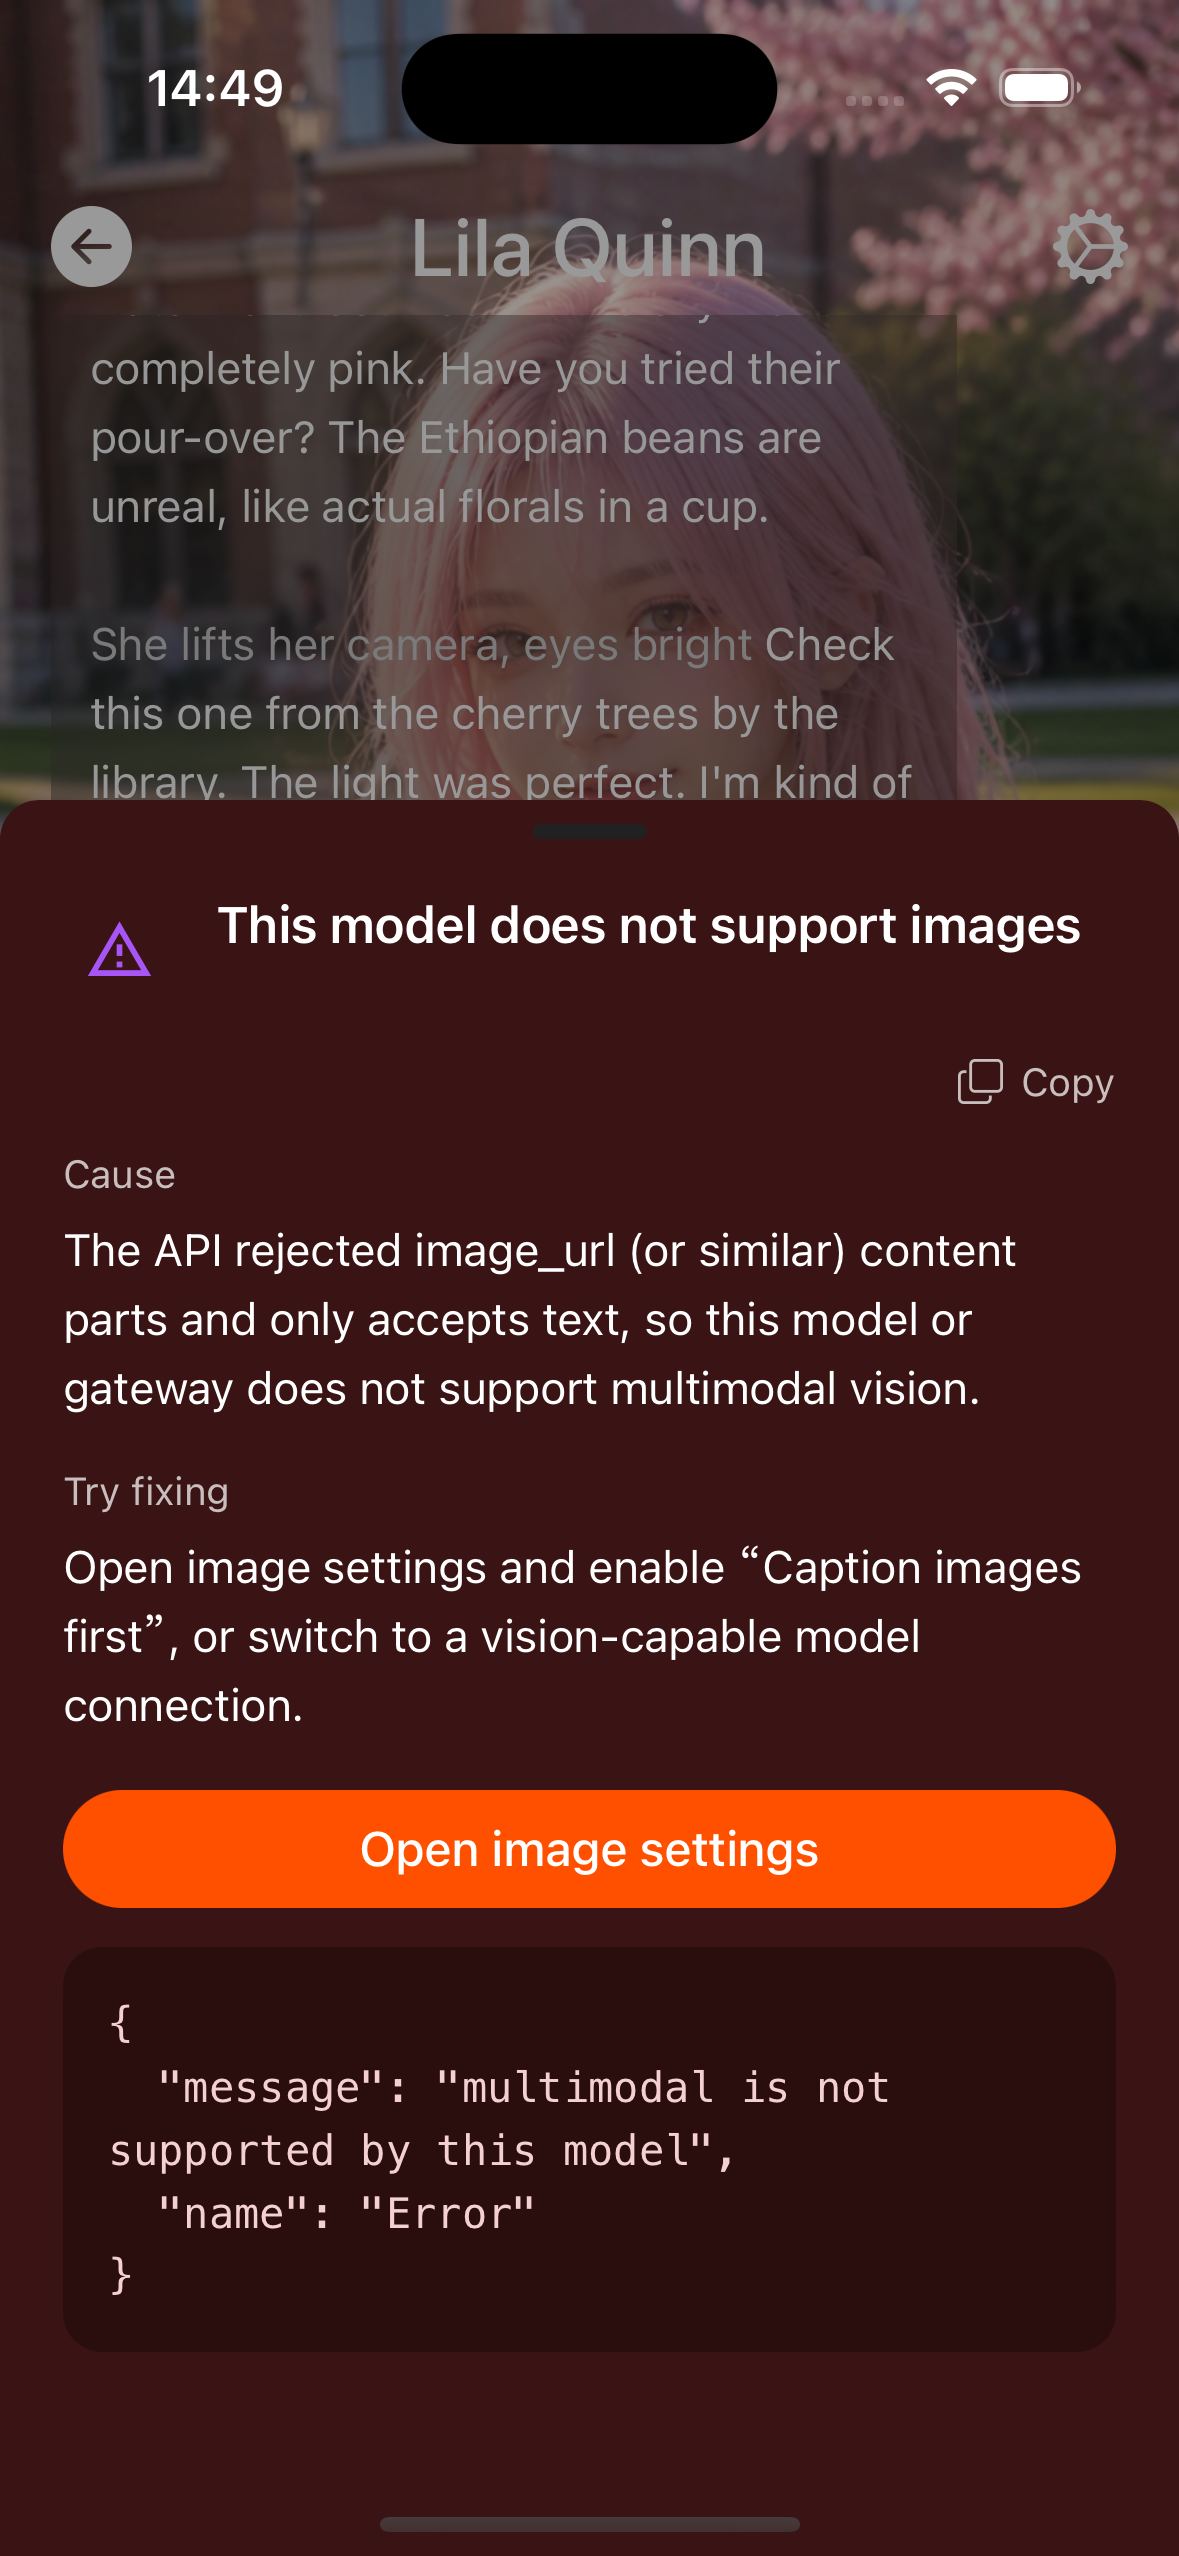
Details enthalten in der Regel:
- Fehlercode (englische ID, z. B.
invalidApiKey) - Ursache
- Fix-Vorschlag
Die «Codes» entsprechen den Namen in den Fehlerdetails der App.
Schnellübersicht
| Fehlercode | Kurz für Nutzer | Priorität |
|---|---|---|
missingApiKey | Bitte zuerst API Key eintragen | Key in der Modellverbindung |
invalidApiKey | Key ungültig oder abgelaufen | vollständig kopieren; in der Konsole neu erzeugen |
forbidden | Zugriff verweigert | Rechte, Modell freigeschaltet? |
regionForbidden | Region nicht verfügbar | Netz / Proxy / internationale Site |
network | Netzwerkfehler | Netz, Base URL, Firewall |
timeout | Timeout | Netz; lokal Timeout erhöhen |
modelNotFound | Modell existiert nicht | Modell-ID prüfen |
modelRetired | Modell offline | aktuelles Modell aus der Liste |
rateLimit | Zu häufig | warten und erneut |
freeTierQuota | Free-Tier-Kontingent | laut Please retry in … warten; seltener oder Upgrade |
insufficientQuota | Kontingent leer | aufladen / anderen Key |
spendingCapExceeded | Monatliches Spend-Cap | Cap in der Konsole erhöhen |
providerReturnedError | Upstream-Fehler | anderes Modell / anderes :free / OpenRouter BYOK |
contextLengthExceeded | Kontext zu lang | Gedächtnis kürzen; Antwort-Token None; größeres Kontextmodell |
anthropicMaxTokensRequired | Claude ohne max_tokens | «Antwort-Token» in Modelleinstellungen |
badRequest | Parameterfehler | Parameter und Kompatibilitätsformat |
serverError | Serverfehler | später erneut |
requestFailed | Request fehlgeschlagen | Originaltext in Details |
contentPolicy | Safety-Filter | neu generieren / Modell wechseln / umschreiben |
emptyContent | Leere Antwort | erneut; Reasoning-Felder prüfen |
modelAtCapacity | Modell ausgelastet | warten oder wechseln |
productNotActivated | Produkt nicht freigeschaltet | in der Konsole aktivieren |
visionUnsupported | Keine Bilder | Vision-Modell oder Anhänge aus |
textOutputUnsupported | Kein Text-Chat | Textmodell wählen, keine TTS-/Bild-ID |
Details nach Kategorie
missingApiKey
- Symptom: ohne Key kein Request.
- Fix: Einstellungen → Modellverbindung → API Key. Lokal Ollama usw. ggf. Platzhalter (wenn Nicht-leer geprüft wird).
invalidApiKey
- Symptom: 401, Key ungültig.
- Fix: ohne Leerzeichen kopieren; CN-/Intl.-Site und Key passen; Key neu erzeugen.
forbidden / regionForbidden
- Symptom: 403, Regionenlimit.
- Fix: Modellrechte; Proxy oder internationale Base URL.
network / timeout
- Symptom: keine Verbindung oder lange keine Antwort.
- Fix:
- Base URL (auf dem Handy kein
localhost— LAN-IP des PCs). - Firewall-Ports; gleiches Wi‑Fi.
- schwaches Netz oder langsames lokales Modell: Timeout hoch, kleineres Modell.
- Base URL (auf dem Handy kein
modelNotFound
- Symptom: falsche Modell-ID.
- Fix: nach Test aus Liste neu wählen; lokal wie
ollama list/ LM Studio-Name.
modelRetired
- Symptom: HTTP 404 mit
no longer available to new users/use a newer model(z. B.models/gemini-2.5-flash-lite). - Unterschied: vom Anbieter abgeschaltet oder nicht für neue Nutzer — kein Tippfehler.
- Fix: Liste aktualisieren, online Gemini wählen (z. B.
gemini-flash-latest). Interactions API nicht nötig. Katalog: Gemini models.
rateLimit
- Fix: seltener senden; warten; Plan upgraden.
freeTierQuota
- Symptom: Gemini u. a.
HTTP 429+generate_content_free_tier_requests(oft limit: 20) mitPlease retry in …s. - Unterschied: Free RPM/RPD, nicht «kein Guthaben» und nicht Projekt-Spend-Cap.
- Fix: Sekunden laut Hinweis warten; Frequenz senken; AI Studio Usage; höhere Limits über Billing/Upgrade. Gemini rate limits.
insufficientQuota / spendingCapExceeded
- Unterschied: Kontingent leer vs. monatliches Projekt-Spend-Cap (später erneut oft nutzlos).
- Fix: aufladen; oder Cap in der Konsole (z. B. Google AI Studio Spend).
providerReturnedError
- Symptom: OpenRouter u. a.
HTTP 429: Provider returned error(häufig bei:free). - Fix: später; anderes freies Upstream; oder OpenRouter BYOK.
contextLengthExceeded
- Fix: Einstellungen → Modelleinstellungen → Gedächtnis kürzen; «Antwort-Token» auf None (falls sinnvoll); größeres Kontextmodell.
anthropicMaxTokensRequired
- Fix: Claude braucht max_tokens → «Antwort-Token» an, nicht None.
badRequest
- Fix: Temperature usw.; echte OpenAI-/Anthropic-Kompatibilität des Gateways.
serverError / requestFailed / modelAtCapacity
- Fix: später; Endpoint/Modell wechseln; bei Dauerfehler Anbieter mit Detailtext kontaktieren.
contentPolicy
- Fix: neu generieren, umschreiben, lockereres Modell; manche NSFW-Karten triggern Output-Filter.
emptyContent
- Fix: erneut; manche Reasoning-Modelle liefern nur reasoning → Detailfelder oder anderes Modell.
productNotActivated
- Fix: Produkt/Modell in der Cloud-Konsole freischalten, denselben Key weiter nutzen.
visionUnsupported
- Fix: Vision-Modell; oder keine Bilder / Bilderkennungs-Beschreibung als Text.
textOutputUnsupported
- Symptom: HTTP 400,
response modalitiesundTEXTnicht unterstützt (z. B.models/gemini-2.5-flash-preview-ttsnurAUDIO). - Unterschied: TTS-/Bild-Spezialmodell für Chat-Test — kein Key-/Sampling-Fehler.
- Fix: Text-Chat-Modell (z. B.
gemini-flash-latest). Keine IDs mittts/image. Stimme/Bild in den jeweiligen Features konfigurieren.
Speziell lokale Modelle
PC Ollama / LM Studio nicht erreichbar: Lokale Fehlerbehebung.
App-Verbindungstest / Chat mit Fehlercode: Handbuch · Fehlercodes.
Screenshot